Qué es, cómo funciona y cómo rinde frente a GPT-6 y otros 7 modelos clasificando correos
En septiembre apareció una nueva familia de modelos de IA que no escribe ni conversa: decide. Jev, de TypeSafe AI, abrió la categoría a mediados de mes, y en apenas tres semanas Perplexity, Cloudflare, Inception y la comunidad open source han publicado sus propias versiones. Prometen clasificar, enrutar y puntuar en milisegundos y por céntimos, sin necesidad de entrenar nada.
La pregunta que nos hicimos en hiberus es la que se haría cualquier equipo que tenga que llevarlos a producción: ¿funciona Jev en castellano, con un problema real de muchas categorías, y mejor que un LLM de los de siempre? Montamos una prueba de concepto para comprobarlo. Aquí explicamos qué es Jev, cómo funciona, en qué destaca, cuándo encaja y qué resultados obtuvimos.
¿Qué es Jev?
Jev es un modelo de decisión. TypeSafe lo llama modelo «System One», en referencia al pensamiento rápido e intuitivo. Un LLM convencional genera texto palabra a palabra; Jev, en cambio, recibe:
- un estado: el texto o el JSON sobre el que hay que decidir, por ejemplo un correo, un ticket o un registro;
- una o varias preguntas tipadas, de tres tipos:
- choice: elegir una opción de una lista;
- noul: responder sí o no;
- score: puntuar en una escala.
Y devuelve directamente la probabilidad de cada respuesta posible, en una sola pasada, sin generar texto. No sirve para redactar, resumir ni conversar: es una pieza especializada en tomar decisiones sobre opciones que tú defines.
Diferencias entre un modelo de decisión y un LLM
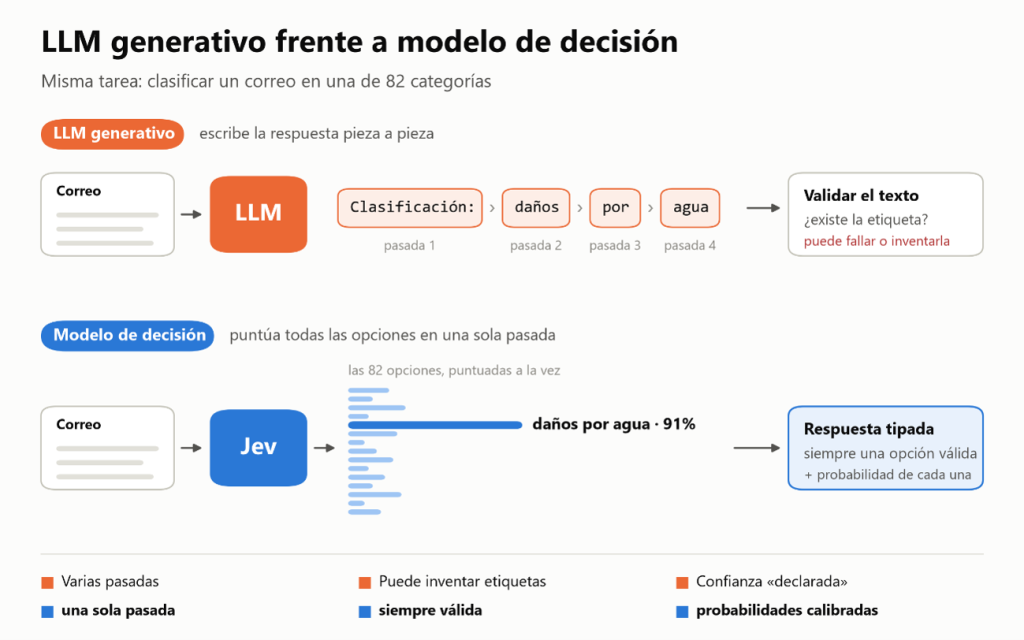
LLM generativo frente a modelo de decisión
| LLM generativo (GPT, Qwen…) | Modelo de decisión (Jev) | |
| Qué devuelve | Texto libre | Una opción tipada + la probabilidad de cada opción |
| Cómo lo produce | Token a token, en varias pasadas | Una sola pasada en paralelo |
| ¿Puede inventarse una etiqueta? | Sí, hay que validar la respuesta | No, siempre devuelve una opción definida |
| Confianza | La que el modelo «declara» si se le pide | Probabilidades nativas y calibradas |
| Coste | Se paga la entrada y la salida | Jev solo cobra la entrada; la salida es gratis |
| Para qué sirve | Redactar, resumir, extraer, razonar, conversar | Clasificar, enrutar, puntuar, filtrar |
No compiten: se complementan. Un patrón muy natural es usar un modelo de decisión para el triaje rápido de todo el volumen y un LLM solo para lo que necesita lenguaje, como redactar la respuesta o resumir el expediente.
¿Cómo funciona Jev por dentro?
TypeSafe no ha publicado la arquitectura completa de Jev, pero sí explica tres ideas clave:
- No es autorregresivo. Evalúa todas las salidas posibles en una sola pasada en paralelo. Por eso responde muy rápido (entre 70 y 500 ms según el fabricante) y nunca devuelve una opción que no exista. Admite hasta 255 opciones por pregunta.
- Está entrenado para estar bien calibrado. TypeSafe usa una técnica propia, Reinforcement Learning for Calibrated Decisions (RLCD), para que, cuando Jev dice «80% de probabilidad», acierte de verdad en torno al 80% de las veces.
- La confianza es una fórmula sencilla. Para una pregunta con n opciones, mide cuánto destaca la opción ganadora frente a un reparto uniforme: (p_max − 1/n) / (1 − 1/n). Un 0 significa que el modelo no tiene ni idea; un 1, que lo tiene claro.
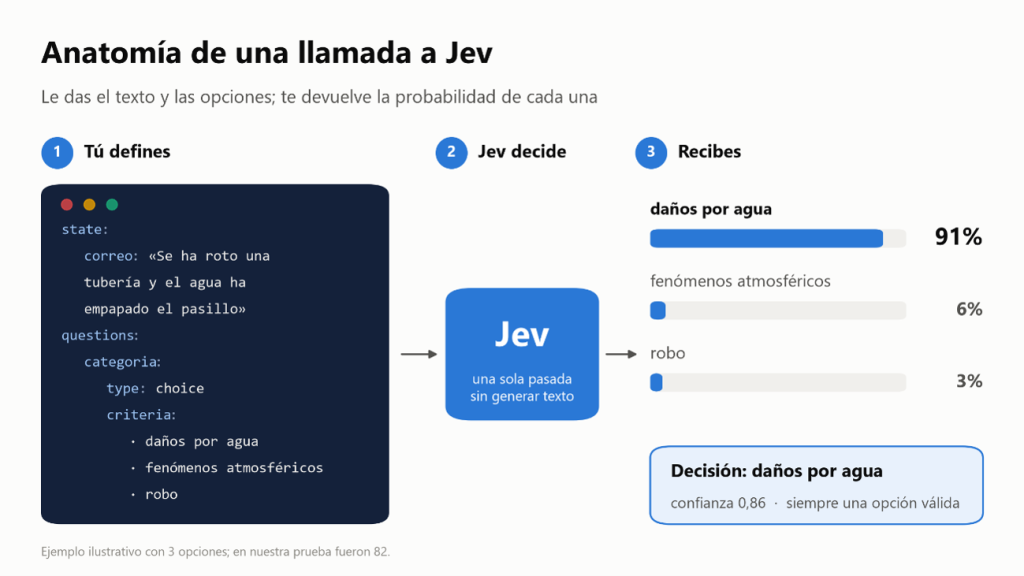
Anatomía de una llamada a Jev
Para ver el mecanismo en detalle hay que mirar a Kev, una alternativa open source que hace lo mismo y publica su código. Kev parte de un LLM normal (Qwen3.5), lee el estado y las opciones una sola vez, sin generar nada, y una pequeña capa final puntúa cada opción a partir de la representación interna del modelo. Es decir: aprovecha lo que el LLM «entiende» del texto, pero se salta la parte cara y arriesgada de escribir.
Así de simple es una llamada a Jev (en este caso, a través de OpenRouter):
import os, requests

resp = requests.post(

    "https://openrouter.ai/api/alpha/decisions",

    headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},

    json={

        "model": "typesafe/jev-1.13",

        "state": {"correo": "Se ha roto una tubería y el agua ha empapado el suelo del pasillo."},

        "questions": {

            "categoria": {

                "type": "choice",

                "instructions": "¿Cuál es la petición principal del correo?",

                "criteria": {

                    "danos_agua": "Fuga o rotura de tubería en la vivienda",

                    "fenomenos_atmosfericos": "Daños por lluvia, viento o granizo",

                    "robo": "Robo o intento de robo",

                },

            },

            "urgente": {"type": "noul", "instructions": "¿Requiere atención el mismo día?"},

        },

    },

)

print(resp.json()["answers"])   # opción elegida, probabilidad de cada opción y P(sí) de la urgencia
Fíjate en que la misma llamada responde dos preguntas a la vez (categoría y urgencia) sobre el mismo correo.
¿Cuáles son las ventajas de Jev?
- Clasifica sin entrenamiento. No hace falta etiquetar miles de ejemplos ni entrenar un modelo: basta con escribir las categorías y una breve descripción de cada una. En nuestra prueba, con 82 categorías en castellano y sin ningún ajuste, alcanzó un 0,90 de macro-F1. Cambiar la taxonomía es editar un texto, no reentrenar.
- Es muy económico. Cuesta 0,042 por cada 100.000 correos**.
- Es rápido. Fue el más rápido de los modelos que pudimos medir en igualdad de condiciones: unos 1,5 segundos por correo desde un portátil, con la red y el intermediario incluidos. El fabricante habla de 70 a 500 ms en su propia infraestructura.
- Siempre devuelve algo válido. La respuesta es siempre una de las opciones definidas, en el formato esperado. Se acabó parsear texto o reintentar respuestas mal formadas.
- Sus probabilidades son fiables. Es su gran baza para producción. Con la confianza que devuelve, en nuestra prueba se podría automatizar el 90% de los correos manteniendo un 95% de precisión y mandar el resto a revisión humana. Su error de calibración fue muy bajo (ECE 0,03).
- Responde varias preguntas a la vez. Categoría, urgencia, «¿requiere respuesta?» o una puntuación de prioridad, todo en una sola llamada y en paralelo sobre el mismo texto.
- Es fácil de integrar y de sustituir. Es una API sencilla, con SDKs y acceso también a través de OpenRouter, Vercel o Cloudflare. Además, varias alternativas usan la misma interfaz, así que cambiar de modelo es cambiar una URL.
¿Cuándo utilizar Jev y cuándo no?
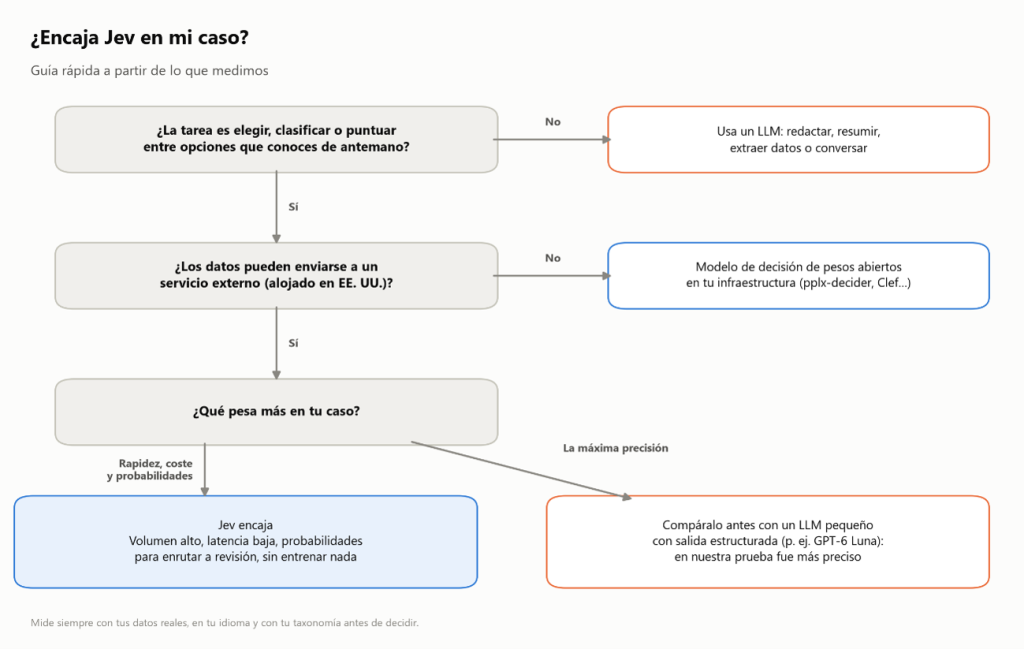
Encaja muy bien para:
- Triaje y enrutado de correos, tickets o formularios hacia el equipo o el proceso adecuado.
- Priorizar y puntuar: urgencia, riesgo, calidad de un lead, sentimiento.
- Moderación y guardrails: decidir si un contenido cumple una política o si la respuesta de un LLM es aceptable antes de enviarla.
- Decisiones dentro de un agente: qué herramienta usar o qué rama seguir, con latencias de milisegundos.
- Preetiquetar datos para que una persona solo revise, en lugar de clasificar desde cero.
- En general, mucho volumen, poca latencia y opciones conocidas de antemano, cuando además interesa saber cuándo fiarse del modelo.
No es la mejor opción si:
- necesitas generar texto: redactar, resumir o extraer campos;
- los datos no pueden salir de tu infraestructura: Jev es un servicio alojado en EE. UU. que no publica región de alojamiento ni subprocesadores;
- la decisión exige contar, calcular o comparar fechas: su propia documentación lo señala como punto débil;
- el texto viene muy cargado de contenido irrelevante: su documentación reconoce que pierde precisión, y recomienda filtrarlo antes y revisar el orden de las opciones, porque tiende a favorecer la primera.
¿Encaja Jev en mi caso?
Un ecosistema de cuatro semanas
| Modelo | Quién | Publicado | Pesos abiertos |
| Jev 1.13 | TypeSafe AI | Mediados de septiembre de 2026 | No (API) |
| Kev (0,8B a 27B) | Jared Palmer (open source) | Finales de septiembre | Sí, Apache-2.0 |
| Mercury Decide | Inception | 30 de septiembre | No (API; versión gratuita en OpenRouter) |
| pplx-decider 27B | Perplexity | 1 de octubre (v1.1, primera semana de octubre) | Sí, Apache-2.0 |
| Clef / Clef-flash | Cloudflare | 1 de octubre | Sí, Apache-2.0 |
| Laya | Convai | Septiembre | Sí, Apache-2.0 (con versión multilingüe) |
La prueba con Jev que hicimos
Planteamos un escenario exigente y realista: la bandeja de entrada de una aseguradora ficticia.
- 82 categorías agrupadas en 8 familias: decesos, siniestros de hogar, siniestros en curso, pólizas, recibos, salud, empresas y atención al cliente. Incluimos a propósito pares difíciles de separar, como «daños por agua» frente a «daños por lluvia», o «recibo devuelto» frente a «cambio de cuenta».
- 164 correos sintéticos en castellano, 2 por categoría, en cuatro niveles de dificultad:
- limpio: un correo normal;
- ruidoso: sin tildes, con erratas y con el típico aviso legal al pie;
- hilo: el mensaje va encima de un correo anterior citado de otro tema;
- multi: el remitente pide además una segunda cosa.
- Zero-shot: ningún modelo se entrena ni se ajusta. Todos reciben lo mismo: la lista de categorías con una breve descripción de qué incluye y qué no cada una.
Comparamos tres tipos de sistema:
- Modelos de decisión: Jev, Mercury Decide, pplx-decider y Kev-4B.
- LLMs generales en la nube: GPT-6 Luna y GPT-6 Sol, con salida estructurada para que solo puedan responder una etiqueta válida.
- LLMs de pesos abiertos: gpt-oss-120b, gpt-oss-20b y Qwen2.5 7B, este último ejecutado en un portátil sin GPU.
Cómo leer las métricas:
- Acierto: porcentaje de correos clasificados en la categoría exacta.
- Macro-F1: calidad media por categoría, de 0 a 1. Penaliza que un modelo falle siempre en ciertas categorías aunque acierte en las frecuentes. Como referencia, usamos un umbral exigente de 0,85.
- Familia: porcentaje de correos enviados al área correcta, aunque falle la categoría concreta.
Resultados
Así se ve la comparativa ejecutada en nuestro entorno de pruebas:
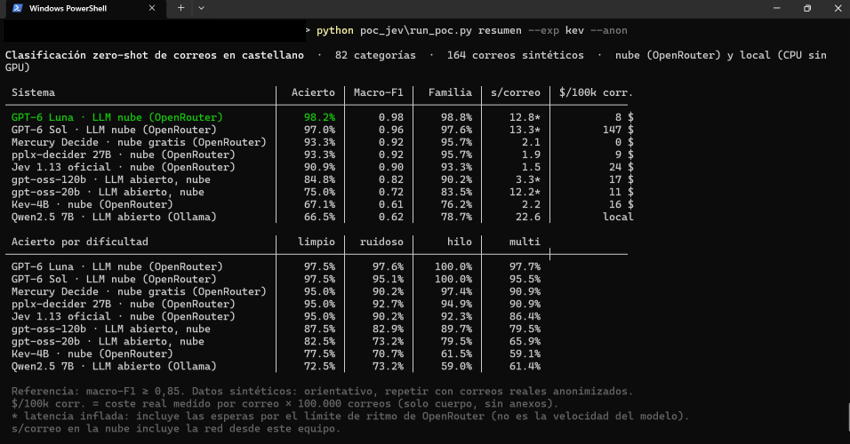
Resultado de la prueba en nuestro entorno: 9 modelos, 164 correos sintéticos en castellano y 82 categorías. Los tiempos marcados con * incluyen las esperas por el límite de peticiones de nuestra cuenta de prueba, no la velocidad real del modelo.
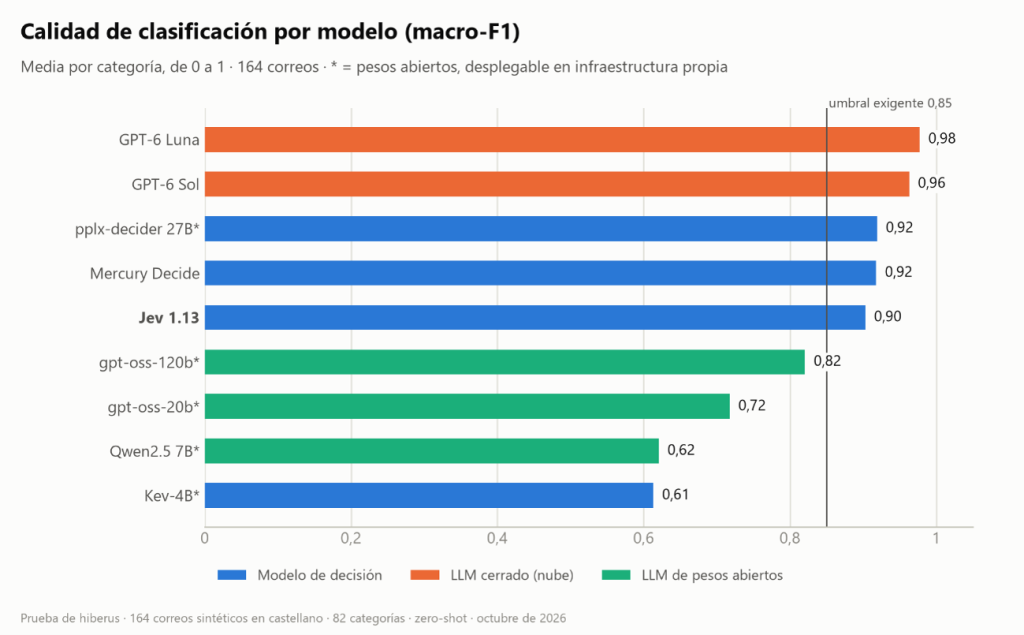
Calidad de clasificación por modelo
| Sistema | Tipo | Acierto | Macro-F1 | Familia | Coste por 100.000 correos* |
| GPT-6 Luna | LLM, nube | 98,2% | 0,98 | 98,8% | 8 $ |
| GPT-6 Sol | LLM, nube | 97,0% | 0,96 | 97,6% | 147 $ |
| Mercury Decide | Decisión, nube | 93,3% | 0,92 | 95,7% | 0 $ (versión gratuita) |
| pplx-decider 27B | Decisión, pesos abiertos | 93,3% | 0,92 | 95,7% | 9 $ |
| Jev 1.13 | Decisión, nube | 90,9% | 0,90 | 93,3% | 24 $ |
| gpt-oss-120b | LLM, pesos abiertos | 84,8% | 0,82 | 90,2% | 17 $ |
| gpt-oss-20b | LLM, pesos abiertos | 75,0% | 0,72 | 83,5% | 11 $ |
| Kev-4B | Decisión, pesos abiertos | 67,1% | 0,61 | 76,2% | 16 $ |
| Qwen2.5 7B | LLM, pesos abiertos (local) | 66,5% | 0,62 | 78,7% | — (local) |
Coste real medido a través de OpenRouter, proyectado a 100.000 correos (solo el cuerpo del mensaje, sin anexos).
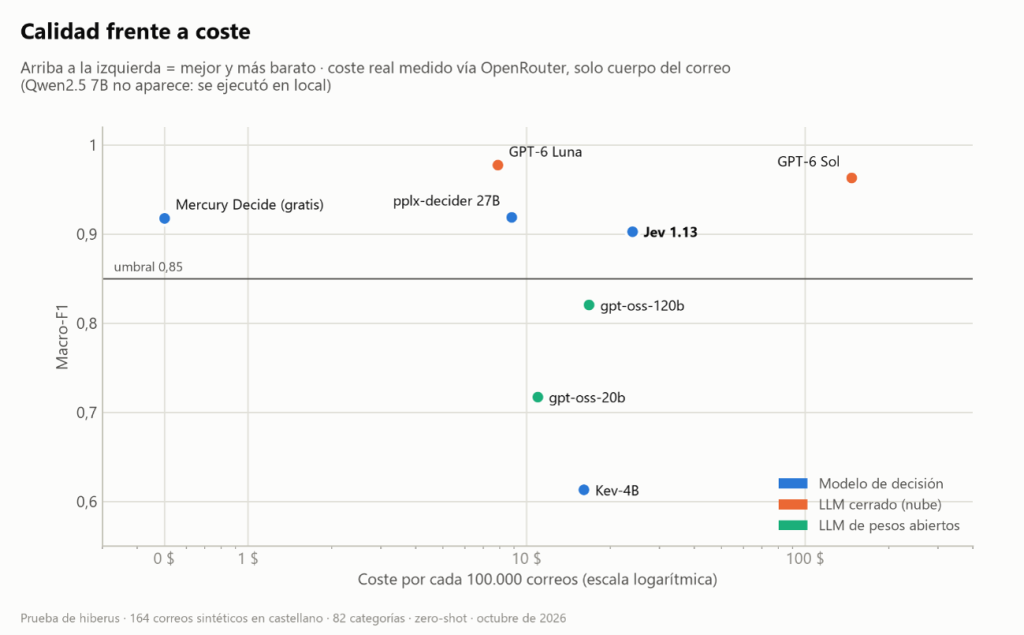
Calidad frente a coste
¿Cuántos correos se pueden automatizar sin revisión?
Acertar no basta: en producción hay que saber cuándo fiarse del modelo. Por eso medimos qué porcentaje de correos se podría clasificar automáticamente manteniendo una precisión del 95%, dejando el resto para revisión humana.
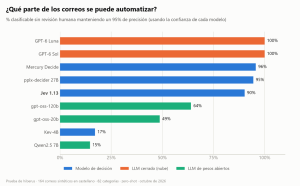
Qué parte de los correos se puede automatizar
En los buenos modelos, la confianza que dan es fiable y permite automatizar casi todo: Jev, el 90% de los correos. En los pequeños no: Qwen solo usa 6 valores distintos de confianza, y la de Kev-4B está muy descalibrada. Un modelo que acierta dos de cada tres correos, pero que no sabe cuándo se equivoca, solo permite automatizar uno de cada seis.
Conclusiones de nuestra prueba con Jev
- Jev y los modelos de decisión cumplen en castellano.Sin ningún ajuste, Jev, Mercury y pplx-decider alcanzan o superan el 0,90 de macro-F1 con 82 categorías, y responden en unos 2 segundos medidos desde un portátil, red incluida.
- Pero no son automáticamente la opción más precisa.Un LLM pequeño de última generación, GPT-6 Luna, con salida estructurada, fue el más preciso de la prueba (0,98) y de los más baratos (8 $ por 100.000 correos). La ventaja de los modelos de decisión no está en la precisión bruta, sino en la latencia, en las probabilidades nativas, en el precio y, en algunos casos, en poder desplegarlos en casa.
- Los pesos abiertos cambian la conversación.pplx-decider empata con Mercury como el mejor modelo de decisión de la prueba, por delante de Jev, y se puede descargar y desplegar en infraestructura propia. Para sectores con datos sensibles (seguros, salud, banca, administración), poder clasificar sin que el dato salga del perímetro suele pesar más que unos puntos de precisión.
- El tamaño importa.Con 82 categorías, los modelos pequeños se quedan lejos: Kev-4B, gpt-oss-20b y Qwen2.5 7B rondan entre 0,6 y 0,7. Y si se piensa en desplegarlos en casa, hay que contar con GPU: Kev-4B en un portátil sin GPU tardaba entre 70 y 100 segundos por correo, frente a unos 2 segundos del mismo modelo servido en la nube.
- El ruido de verdad está en los hilos.Los modelos más débiles caen con fuerza cuando el correo arrastra un mensaje anterior citado de otro tema: Qwen y Kev se quedan en torno al 60%, frente al 97-100% de los mejores. En producción, limpiar el texto citado antes de clasificar es una mejora barata y de gran impacto.
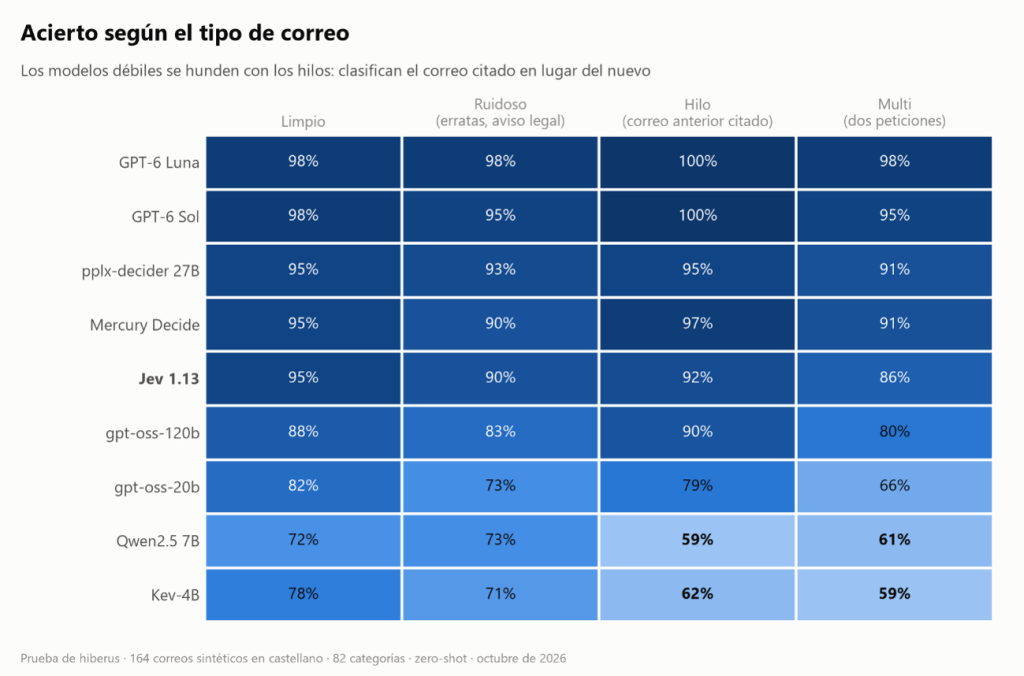
Acierto según el tipo de correo
- El coste de inferencia es casi irrelevante.Entre 0 y 25 $ por cada 100.000 correos para casi todas las opciones. En un proyecto real, el coste está en la integración, la extracción de anexos, la protección del dato, la validación con negocio y la operación, no en el modelo.
- Cuidado con los atajos.Probamos también jeff, una reimplementación open source de Jev basada en un modelo entrenado en inglés: en castellano no pasó del 13% de acierto. Y al buscar acceso a Jev encontramos webs no oficiales que revenden o imitan el servicio, sin operador identificado y sin decir qué modelo responde. Para una prueba con datos ficticios puede valer; con datos de clientes, nunca.
Las limitaciones de esta prueba
- Son correos sintéticos. Están generados a partir de plantillas y son más regulares que los reales. Que los mejores modelos rocen el 95-98% indica que la prueba es asequible para un modelo potente. Sirve para descartar opciones y ordenar candidatos, no para prometer esas cifras con correos reales, que traen anexos, hilos largos y categorías más ambiguas.
- La muestra es pequeña (164 correos). Diferencias de 1 o 2 puntos entre modelos no son significativas.
- Las latencias de algunos LLM en nuestras pruebas están condicionadas por los límites de una cuenta nueva, así que no las usamos para compararlos.
Jev cumple lo que promete: clasifica en castellano sin entrenamiento, es barato, rápido y sabe cuándo puede equivocarse. No es el más preciso de nuestra prueba (un LLM pequeño de última generación lo supera) ni se puede desplegar en casa (para eso están alternativas abiertas como pplx-decider). Pero para triaje, enrutado y decisiones de alto volumen donde los datos pueden ir a un servicio externo, es una pieza muy atractiva, y la mejor noticia es que, con interfaces compatibles y pesos abiertos, probarlo y cambiar de modelo nunca había sido tan barato.
La recomendación de siempre sigue valiendo: mide con tus datos reales, en tu idioma y con tu taxonomía, y define antes de mirar los resultados qué cifra consideras suficiente.
¿Estás valorando automatizar la clasificación de correos, tickets o documentos? En hiberus te ayudamos a medir qué solución necesitas antes de construirla.
Preguntas frecuentes sobre Jev
¿Qué es Jev?
Un modelo de IA de TypeSafe AI, lanzado en septiembre de 2026, que no genera texto: recibe un texto y unas preguntas cerradas y devuelve la probabilidad de cada respuesta. Está pensado para clasificar, enrutar y puntuar.
¿Jev funciona en español?
En nuestra prueba, sí: alcanzó un 0,90 de macro-F1 clasificando correos en castellano en 82 categorías, sin ningún ajuste. TypeSafe no publica evaluaciones en español.
¿Cuánto cuesta Jev?
0,042 por millón de tokens de entrada; la salida es gratis. En nuestra prueba salió por unos 24 por cada 100.000 correos.
¿Hay que entrenar Jev?
No. Basta con definir las opciones y una breve descripción de cada una. Si cambian las categorías, se cambia el texto de la pregunta.
¿Se puede instalar Jev en local?
No: Jev solo está disponible como API. Hay alternativas de pesos abiertos con la misma interfaz, como pplx-decider o Kev, que sí se pueden desplegar en infraestructura propia (con GPU).
¿Es mejor que un LLM como GPT?
Depende de para qué. En nuestra prueba, GPT-6 Luna con salida estructurada fue más preciso y más barato. Jev aporta latencia muy baja, probabilidades calibradas de serie y respuestas siempre válidas. Para redactar o resumir, un LLM; para decidir rápido y a escala, un modelo de decisión.
Fuentes
- TypeSafe AI, Introducing System One models and Jev: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Documentación de TypeSafe (modelos, primitivas, confianza, limitaciones de Jev 1.13): https://docs.typesafe.ai
- OpenRouter, guía de Jev: https://openrouter.ai/docs/guides/community/jev
- Kev (Jared Palmer): https://github.com/jaredpalmer/kev
- jeff (reimplementación open source de la API de Jev): https://github.com/logan-markewich/jeff
- GLiFormer-large, modelo usado por jeff: https://huggingface.co/knowledgator/gliformer-large-v1
- The Batch (DeepLearning.AI), Models built to do one thing well: https://www.deeplearning.ai/the-batch/models-built-to-do-one-thing-well
- Directorio de modelos de decisión: https://systemonemodels.org/models/